[Research & Insight]망막 혈관·시신경 자동 분할, GAN으로 더 정확해질까 — 가는 혈관까지 잡아낸 RetinaGAN (J Digit Imaging 2019 리뷰)
 망막 혈관·시신경 자동 분할, GAN으로 더 정확해질까 — 가는 혈관까지 잡아낸 RetinaGAN (J Digit Imaging 2019 리뷰) — 핵심 요약
*Journal of Digital Imaging* 2019 연구 리뷰 (Son·Park·Jung) — RetinaGAN
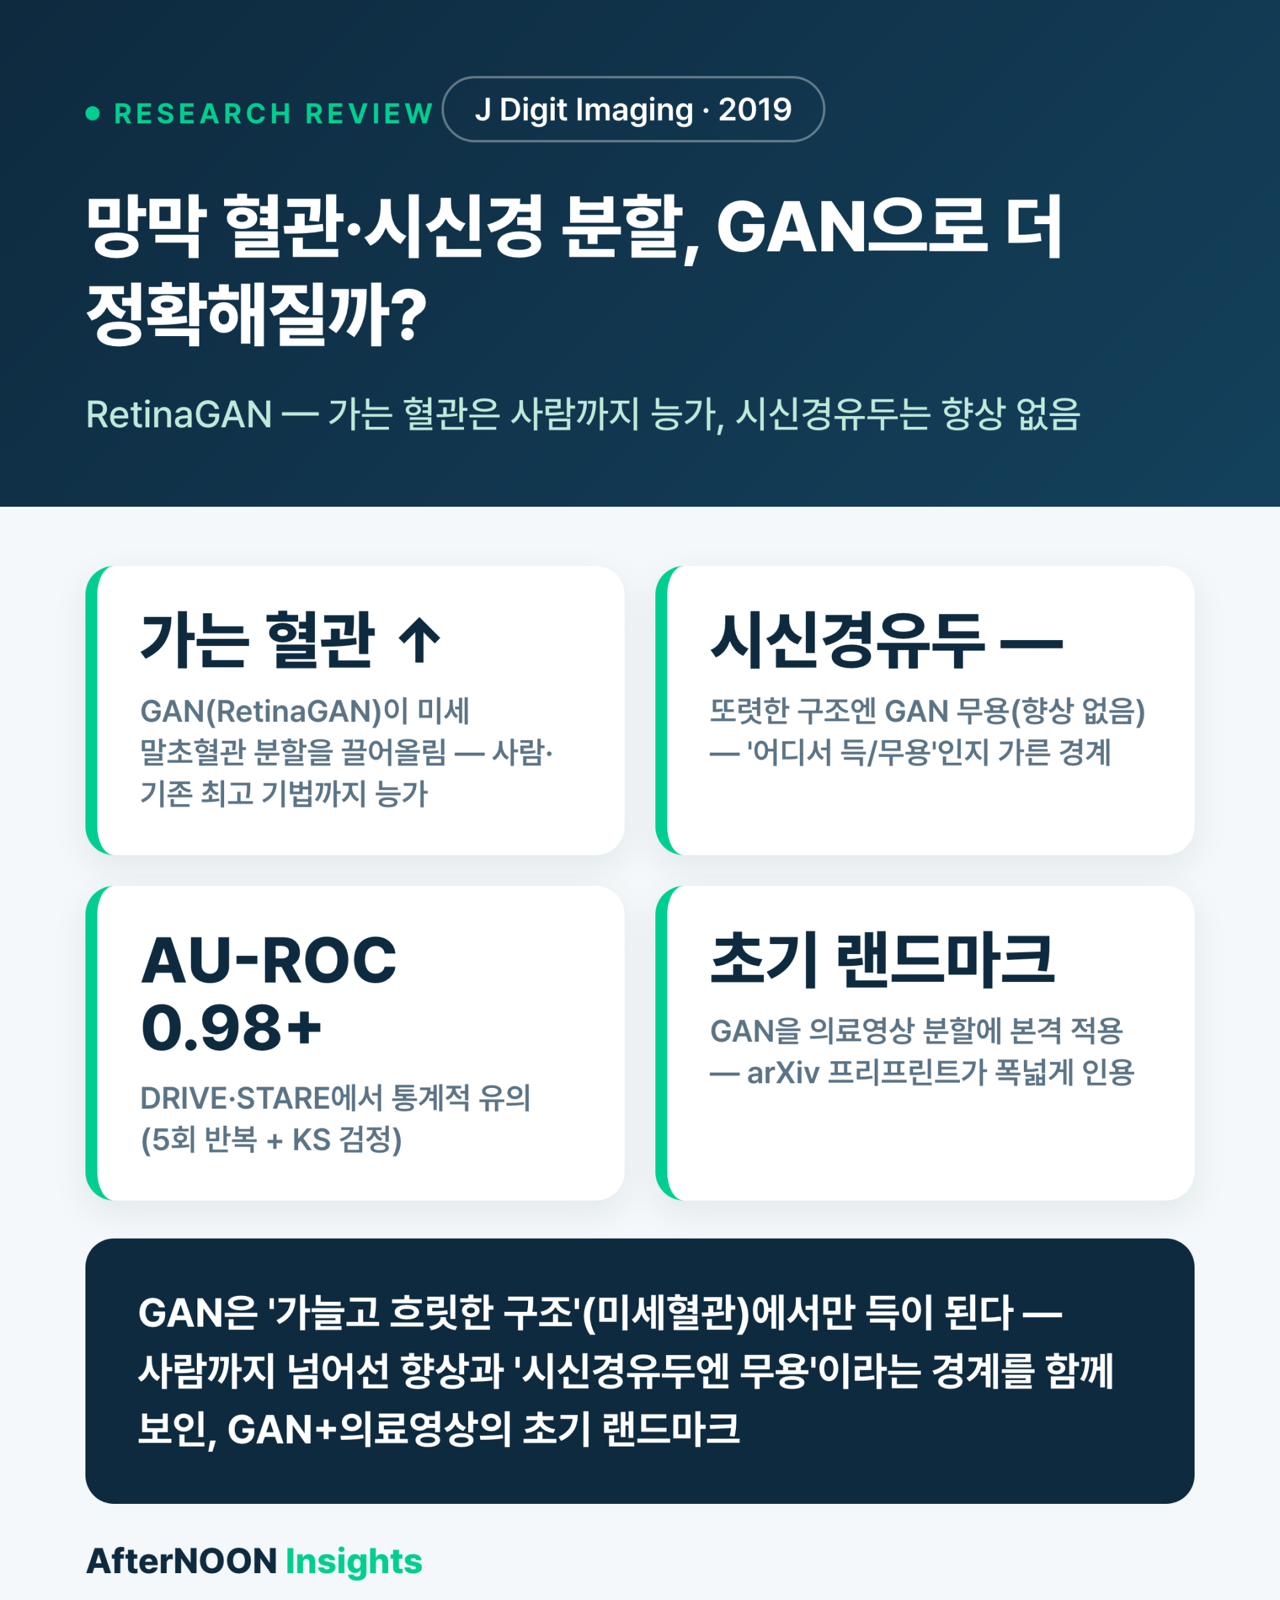
안저사진 속 망막 혈관과 시신경을 AI가 자동으로 그려낼 때, '적대적 생성 신경망(GAN)'을 더하면 무엇이 달라질까? 이 연구의 답은 "혈관에서는 의미 있게 좋아진다"이다 — 특히 사람 눈에도 잘 안 보이는 가느다란 말초 혈관을 더 잘 잡아내며 당시 최고 성능 기법은 물론 사람 판독자까지 넘어섰다. 다만 시신경유두(optic disc) 분할에서는 GAN을 더해도 통계적으로 의미 있는 향상이 없었다 — 시신경유두는 이미 또렷한 덩어리라 기본 신경망만으로도 충분히 잘 그려졌기 때문이다. 이 *Journal of Digital Imaging* 논문(2019, 온라인 선공개 2018)은 "어떤 구조에서 GAN이 득이 되고 어디서는 무용한지"를 가른 방법론 연구다.
🔎 이해상충 투명 고지: 본 논문의 공동 제1저자(Sang Jun Park, 박상준)는 본 플랫폼 운영사(CLOP)의 공동대표이자 서울대학교 의과대학 안과 교수입니다. 본 논문에서 박상준의 소속은 분당서울대학교병원 안과로 표기되어 있으며, 다른 두 공동저자는 연구 당시 분석기업 VUNO 소속이었습니다. 박상준은 현재 VUNO 지분을 보유하고 있지 않습니다. 이 글은 학술 정보 제공을 목적으로 하며, 특정 제품·의료기관·진료의 권유가 아닙니다.
서지정보 · *Journal of Digital Imaging* 2019;32(3):499–512 (online first 2018) · PMID 30291477 · DOI 10.1007/s10278-018-0126-3
핵심 요약
- 무엇: 안저사진에서 망막 혈관과 시신경유두를 픽셀 단위로 자동 분할하는 딥러닝에 GAN 프레임워크(RetinaGAN)를 적용해, 일반 신경망(U-Net) 대비 성능이 얼마나 오르는지를 실험으로 측정.
- 핵심 발상: 분할을 '안저사진 → 분할지도(확률맵)'를 만드는 영상 변환 문제로 보고, 출력이 사람이 그린 정답과 닮도록 판별자(discriminator)가 압박하게 함.
- 혈관 결과: DRIVE·STARE 두 공개 데이터셋에서 U-Net 대비 AU-ROC·AU-PR이 통계적으로 유의하게 상승. 최고 모델(Image GAN)은 기존 최고 기법(DRIU)을 AU-ROC 0.2~1.0%, AU-PR 0.8~1.2%, Dice 0.5~0.7% 앞섰고 사람 판독자도 능가.
- 시신경유두 결과: DRIONS-DB·RIM-ONE·Drishti-GS 세 데이터셋에서 GAN을 더해도 유의한 향상 없음(U-Net이 이미 AU-ROC 0.999대). 또렷한 덩어리 구조는 GAN이 굳이 필요 없다는 신호.
- 의미: 무조건 GAN을 쓰는 게 아니라, '가늘고 흐릿한 구조'(미세혈관)에서만 GAN이 득이라는 점을 가른 방법론적 좌표. 미세혈관 정밀 분할은 혈관 지름·굴곡 같은 정량 분석의 전제가 된다.
이 연구가 한 일은?
안저사진(눈 안쪽 망막을 찍은 사진)에서 혈관이 지나가는 자리와 시신경유두(시신경이 빠져나가는 둥근 구조)의 윤곽을 컴퓨터가 자동으로 그려내는 것을 '분할(segmentation)'이라고 한다. 이 분할이 정확해야 혈관의 지름·굴곡·분지각 같은 수치(geometry)를 믿고 계산할 수 있고, 자동 진단의 토대가 된다.
기존에는 합성곱 신경망(CNN, 특히 U-Net)이 이 일을 잘했지만, 아주 가느다란 말초 혈관 주변에서 결과가 흐릿하게 뭉개지는 약점이 있었다. 이 연구는 여기에 GAN(적대적 생성 신경망)을 얹었다. GAN은 그림을 만드는 '생성자'와 그게 진짜 사람 그림인지 가짜인지 가려내는 '판별자'가 서로 겨루며 학습하는 구조다. 생성자가 그린 분할지도가 사람이 손으로 그린 정답과 구분되지 않을 만큼 사실적이 되도록 판별자가 계속 압박하게 만든 것이다. 연구진은 이 틀을 RetinaGAN이라 부르고, 판별자의 '판단 단위'를 픽셀 한 점부터 이미지 전체까지 4가지(Pixel·Patch-1·Patch-2·Image GAN)로 바꿔가며 비교했다.
왜 (지금) 이 논문이 의미가 있나?
[먼저, 쉽게] 망막 혈관과 시신경 분할은 단순한 그림 그리기가 아니다. 망막 혈관의 지름·굴곡은 관상동맥질환·당뇨병·치매·심혈관 위험까지 가늠하는 '창문'으로 알려져 있고, 시신경유두 평가는 녹내장 진단의 핵심이다. 그래서 혈관·시신경을 정확히, 사람 손을 거치지 않고 그려내는 일은 자동 안저 분석의 출발점이다. 2010년대 중반 CNN(U-Net 등)이 이 분야를 크게 끌어올렸지만, 가느다란 혈관에서 한계가 남아 있었다.
[조금 더 깊이] 당시 CNN 분할의 본질적 약점은 손실함수가 픽셀 단위 비교에만 의존한다는 데 있었다. 가는 혈관은 전체 픽셀에서 차지하는 비중이 워낙 작아, 그것을 놓쳐도 손실이 거의 늘지 않는다 — 그래서 모델이 미세혈관을 '버리는' 쪽으로 학습되기 쉽다. 이 논문은 GAN의 판별자가 "사람 정답에는 있는데 네 결과엔 빠진 가는 혈관"까지 추가로 벌점을 주도록 만들어 이 틈을 메웠다. 즉, 단순히 더 큰 모델을 쓴 게 아니라 무엇을 놓치면 안 되는지를 학습 신호 자체에 새겨 넣은 설계다. 동시에 이 논문은 그 반대도 분명히 보였다 — 시신경유두처럼 또렷한 덩어리에서는 U-Net만으로도 이미 충분해서 GAN이 더할 게 없었다. "어디서 GAN이 득이고 어디서 무용한지"를 같은 실험틀 안에서 가른 것이 이 연구의 자리다.
어떻게 했나? — 데이터와 모델
- 모델 구조(핵심): 생성자는 U-Net 형태의 신경망으로 안저사진을 입력받아 혈관/시신경의 확률맵(0~1)을 만든다. 판별자는 '사진+확률맵' 쌍을 보고 그 분할이 사람 정답인지 생성자가 만든 가짜인지 판정한다. 판별자의 판단 범위(receptive field)를 픽셀(1×1)·작은 패치(8×8)·큰 패치(64×64)·이미지 전체(640×640)로 바꾼 4가지 변형을 비교했다.
- 목적함수: GAN 손실(사실성)과 분할 손실(정답과의 거리, 이진 교차엔트로피)을 가중치 λ로 합쳐 학습(실험에서 λ=10). 사실성과 정확성을 동시에 압박하는 구조.
- 혈관 데이터: 공개 데이터셋 DRIVE(40장, 20/20 학습·시험)와 STARE(20장). 두 명의 독립 판독자 라벨 중 한 명을 정답, 다른 한 명을 '사람 비교 기준점'으로 사용.
- 시신경유두 데이터: DRIONS-DB(110장)·RIM-ONE(r3)(159장)·Drishti-GS(101장) 세 공개 데이터셋. Drishti-GS는 경력이 다른 안과의 4명의 라벨을 평균해 정답을 만듦.
- 평가지표·검증: AU-ROC(ROC 곡선 아래 면적)와 AU-PR(정밀도-재현율 곡선 아래 면적), 그리고 Dice 계수. 같은 설정으로 5회 반복 실험 후 Kolmogorov-Smirnov 검정으로 향상의 통계적 유의성(p값)을 검증. 측정은 시야(FOV) 안쪽 픽셀만 계산해 공정성을 확보.
결과는? — 숫자로
- 혈관 분할 — GAN의 명백한 이득: DRIVE에서 Image GAN의 AU-ROC 0.9810, AU-PR 0.9134로 판별자 없는 U-Net(0.9671 / 0.8898)을 통계적으로 유의하게 앞섰다(p<0.05). STARE에서도 Image GAN AU-ROC 0.9858로 U-Net(0.9736)을 능가. 판별자가 깊고 복잡할수록(Image GAN > Patch > Pixel) 더 좋았다.
- 기존 최고 기법·사람까지 능가: 종합 비교(Table 2)에서 RetinaGAN(Image)은 DRIVE AU-ROC 0.9810·Dice 0.8275, STARE AU-ROC 0.9873·Dice 0.8378로 당시 최고 기법 DRIU(DRIVE 0.9793, STARE 0.9772)와 사람 판독자(Dice DRIVE 0.7889, STARE 0.7605)를 모두 앞섰다. 향상의 본질은 숫자상 작아 보여도 전부 '가는 혈관'에서 나왔다.
- 시신경유두 분할 — GAN 무의미: DRIONS-DB·RIM-ONE·Drishti-GS 세 데이터셋 모두에서 GAN을 더해도 AU-ROC·AU-PR에 통계적으로 유의한 향상이 없었다(모든 쌍 p>0.2). U-Net이 이미 AU-ROC 0.999대로 거의 완벽했기 때문이다.
- 여전한 한계도 보임: 1픽셀 폭의 극도로 가는 혈관은 여전히 놓치거나(빨강) 잘못 추가(파랑)되었다. '혈관은 끊기지 않고 이어진다'는 해부학적 지식을 모델이 갖지 못해서다.
이 논문의 중요성 — 4가지 관점
① 분야 흐름에서의 위치 — 'CNN 그다음'을 가른 방법론 좌표. 2015~2017년 망막 분할의 표준은 U-Net·DRIU 같은 CNN 단독 기법이었고, 이들은 이미 사람을 넘어선다고 보고됐다. 이 논문은 거기에 GAN(적대적 학습)을 결합해, CNN이 구조적으로 버리던 미세혈관을 회수했다 — 그리고 결정적으로, GAN이 모든 구조에 만능이 아니라 '가늘고 흐릿한 구조에서만 득'이라는 경계를 같은 실험틀로 못 박았다. '무조건 최신 기법'이 아니라 '구조의 성질에 따라 기법을 고른다'는 좌표를 남겼다. 이 작업은 GAN을 의료영상(망막) 분할에 본격 적용한 초기 랜드마크 중 하나다 — 2017년 공개된 프리프린트(*Retinal Vessel Segmentation in Fundoscopic Images with Generative Adversarial Networks*, arXiv:1706.09318)는 이후 의료영상 GAN 연구들에서 폭넓게 인용되며, 지금은 흔해진 'GAN+의료영상' 흐름의 이른 출발점 중 하나로 분야 형성에 기여했다.
② 논문 자체의 기여 — 손실 신호에 '놓치면 안 되는 것'을 새긴 설계. 본질적 신규성은 더 큰 모델이 아니라, 판별자가 "정답엔 있는데 빠진 가는 혈관"에 추가 벌점을 주게 한 학습 설계에 있다. 그 결과 Image GAN은 당시 최고 기법 DRIU를 AU-ROC 0.2~1.0%, Dice 0.5~0.7% 앞서며 두 공개 데이터셋에서 최고 성능에 올랐고, 5회 반복+KS 검정으로 향상의 유의성을 통계적으로 뒷받침했다. 동시에 시신경유두에서는 p>0.2로 향상 없음을 정직하게 보고해, '되는 곳/안 되는 곳'을 함께 제시한 점에서 믿을 만하다.
③ 임상·연구 현장에서의 의미 — 정량 분석의 전제를 단단히. 이 모델의 자리는 진단 그 자체가 아니라 그 앞단의 정밀 측정이다. 혈관 지름·굴곡·분지각 같은 수치는 관상동맥질환·당뇨병·심혈관 위험과 연결되는데, 이 수치는 혈관 윤곽이 정확해야 비로소 믿을 수 있다. 기존 기법(DRIU)은 가는 혈관과 큰 줄기를 과도하게 두껍게 그려 혈관 구경 측정을 망치는 경향이 있었는데, RetinaGAN은 확률을 더 사실적으로 표현해 정량 연구에 더 적합한 분할지도를 내놓았다. 다만 1픽셀 혈관·해부학적 연결성은 여전히 후처리가 필요하다 — 자동 측정의 완성이 아니라 정밀화다.
④ 한국 + AfterNOON 관점에서의 의미. 망막 혈관·시신경 자동 분할은 국가검진에서 대량 생산되는 한국의 안저사진을 정량 지표로 바꾸는 기반 기술이다. 사람이 일일이 혈관을 그릴 수 없는 대규모 스크리닝에서, 신뢰할 수 있는 자동 분할은 당뇨망막병증·고혈압성 변화·녹내장 평가의 전제가 된다. AfterNOON의 안과 네트워크 기반 당뇨망막병증 스크리닝·RWD 맥락에서도, 이런 분할 정밀도는 영상 기반 정량 지표의 품질을 좌우하는 토대 기술이다.
짚어둘 한계는?
- 극세 혈관·해부학 지식 부재: 1픽셀 폭 혈관은 여전히 놓치거나 잘못 추가된다. '혈관은 끊기지 않고 이어진다', '급한 각도로 분지한다' 같은 해부학적 지식을 모델이 명시적으로 쓰지 않기 때문이며, 영역 성장·형태학 후처리가 필요하다고 저자도 인정.
- 작은 공개 데이터셋: DRIVE 40장·STARE 20장 등 데이터 규모가 작아 회전·반전 등 대규모 증강에 의존. 더 크고 다양한 실제 임상 데이터에서의 일반화는 별도 과제.
- 시신경유두는 GAN 무용: 또렷한 덩어리 구조에서는 GAN이 향상을 못 줬다. 이 기법의 이득이 구조의 성질에 한정된다는 점을 분명히 인식해야 한다.
- 분할 ≠ 진단: 이 연구는 혈관·시신경을 '그리는' 단계까지다. 질병 판정·전향적 임상 검증은 이 논문 범위 밖이다.
그래서 무엇을 시사하나?
"안저사진 → 혈관·시신경 자동 분할"의 정확도, 특히 가는 혈관까지 사실적으로 그려내는 능력은 자동 안저 분석의 토대다. 이 논문은 GAN이 그 토대를 한 단계 단단하게 만들 수 있음을, 동시에 모든 구조에 만능은 아님을 함께 보였다. AI 영상 기법을 도입할 때 '최신이라서'가 아니라 '이 구조에서 정말 득이 되는가'를 따져야 한다는 실무 교훈이기도 하다. 임상 적용은 정량 측정의 신뢰성·후처리·검증이 함께 설계될 때 비로소 의미를 갖는다.
자주 묻는 질문 (FAQ)
Q1. 이 연구의 AI가 병을 진단하나요?
아닙니다. 이 연구는 안저사진에서 혈관과 시신경의 윤곽을 자동으로 그려내는('분할') 기반 기술을 다룹니다. 진단은 그 정확한 분할 위에서 이루어지는 다음 단계이며, 이 논문의 범위 밖입니다. 진단·치료는 안과 전문의의 영역입니다.
Q2. 'GAN(적대적 생성 신경망)'이 무엇인가요?
그림을 만드는 '생성자'와 그게 진짜인지 가짜인지 가려내는 '판별자'가 서로 겨루며 학습하는 AI 구조입니다. 이 연구에서는 AI가 그린 혈관 지도가 사람이 손으로 그린 정답과 구분되지 않을 만큼 사실적이 되도록, 판별자가 계속 압박해 정밀도를 끌어올렸습니다.
Q3. 왜 '가는 혈관'을 잘 잡는 게 중요한가요?
망막 혈관의 지름·굴곡 같은 수치는 당뇨병·고혈압·심혈관 위험과 연결되는 지표인데, 이 수치는 가는 혈관까지 정확히 그려져야 믿을 수 있습니다. 기존 기법은 가는 혈관을 흐릿하게 뭉개거나 과도하게 두껍게 그려 측정을 왜곡하는 경향이 있었습니다.
Q4. 정확도 'AU-ROC 0.98'은 무슨 뜻인가요?
AU-ROC는 분류 성능을 0~1(또는 0~100%)로 나타내는 지표로, 1에 가까울수록 정확하고 0.5면 무작위 추측 수준입니다. 이 연구의 0.98대는 혈관 픽셀을 매우 잘 구분했다는 뜻이며, 향상폭은 숫자상 작아 보여도 그 차이가 거의 전부 '가는 혈관'에서 나왔다는 점이 핵심입니다.
Q5. 시신경유두는 왜 GAN으로 좋아지지 않았나요?
시신경유두는 주변보다 밝고 또렷한 둥근 덩어리라, 기본 신경망(U-Net)만으로도 이미 거의 완벽하게(AU-ROC 0.999대) 그려졌기 때문입니다. 이미 충분히 잘 되는 일에는 GAN을 더해도 향상의 여지가 거의 없다는 것을 보여줍니다.
Q6. 이 기술이 지금 병원에서 바로 쓰이나요?
이 논문은 공개 데이터셋에서 방법을 검증한 연구 단계의 결과입니다. 실제 임상·정량 분석에 쓰려면 더 크고 다양한 데이터에서의 일반화, 해부학적 후처리, 임상 검증이 추가로 필요합니다.
더 알아보기
눈 건강과 안과 영상·검사에 대한 더 많은 연구 리뷰·정보는 AfterNOON Insights에서 확인하실 수 있습니다 → afternoon.clop.ai
진단과 치료에 대한 판단은 담당 안과 전문의와 상의하세요. (본 글은 학술 정보로, 진단·치료의 근거가 아닙니다.)
출처 (Sources)
- Son J, Park SJ, Jung KH. Towards Accurate Segmentation of Retinal Vessels and the Optic Disc in Fundoscopic Images with Generative Adversarial Networks. *Journal of Digital Imaging*. 2019;32(3):499-512. doi:10.1007/s10278-018-0126-3 (PMID 30291477)
· (초기 프리프린트) Son J, Park SJ, Jung KH. Retinal Vessel Segmentation in Fundoscopic Images with Generative Adversarial Networks. *arXiv*:1706.09318. 2017.
- Goodfellow I, Pouget-Abadie J, Mirza M, et al. Generative adversarial nets. *Advances in Neural Information Processing Systems*. 2014:2672-2680.
- Ronneberger O, Fischer P, Brox T. U-Net: Convolutional networks for biomedical image segmentation. *MICCAI*. 2015:234-241.
- Maninis KK, Pont-Tuset J, Arbeláez P, Van Gool L. Deep retinal image understanding (DRIU). *MICCAI*. 2016:140-148.
- Isola P, Zhu JY, Zhou T, Efros AA. Image-to-image translation with conditional adversarial networks. *IEEE CVPR*. 2017.
- Staal J, Abràmoff MD, Niemeijer M, Viergever MA, van Ginneken B. Ridge-based vessel segmentation in color images of the retina (DRIVE). *IEEE Trans Med Imaging*. 2004;23(4):501-509.
함께 보면 좋은 글
- 중심망막동맥폐쇄와 뇌졸중 평가: 의심되면 어떤 안과 검사가 필요할까
- 혈압 변동과 망막 및 시신경이 의심되면 어떤 안과 검사가 필요할까
- 미숙아망막병증 선별검사, 언제 시작하고 왜 놓치면 안 될까요?
참고 자료
이 글은 안과 전문의 박상준(분당서울대학교병원 안과)의 감수를 받았습니다.
본 콘텐츠는 일반 건강정보이며, 진단과 치료는 담당 안과 전문의와 상담하세요.