[Research & Insight]안저사진 AI는 어떻게 ‘배우나’ — 안과의 57명·8만 장으로 만든 다차원 판독 데이터셋 (JKMS 2018 리뷰)
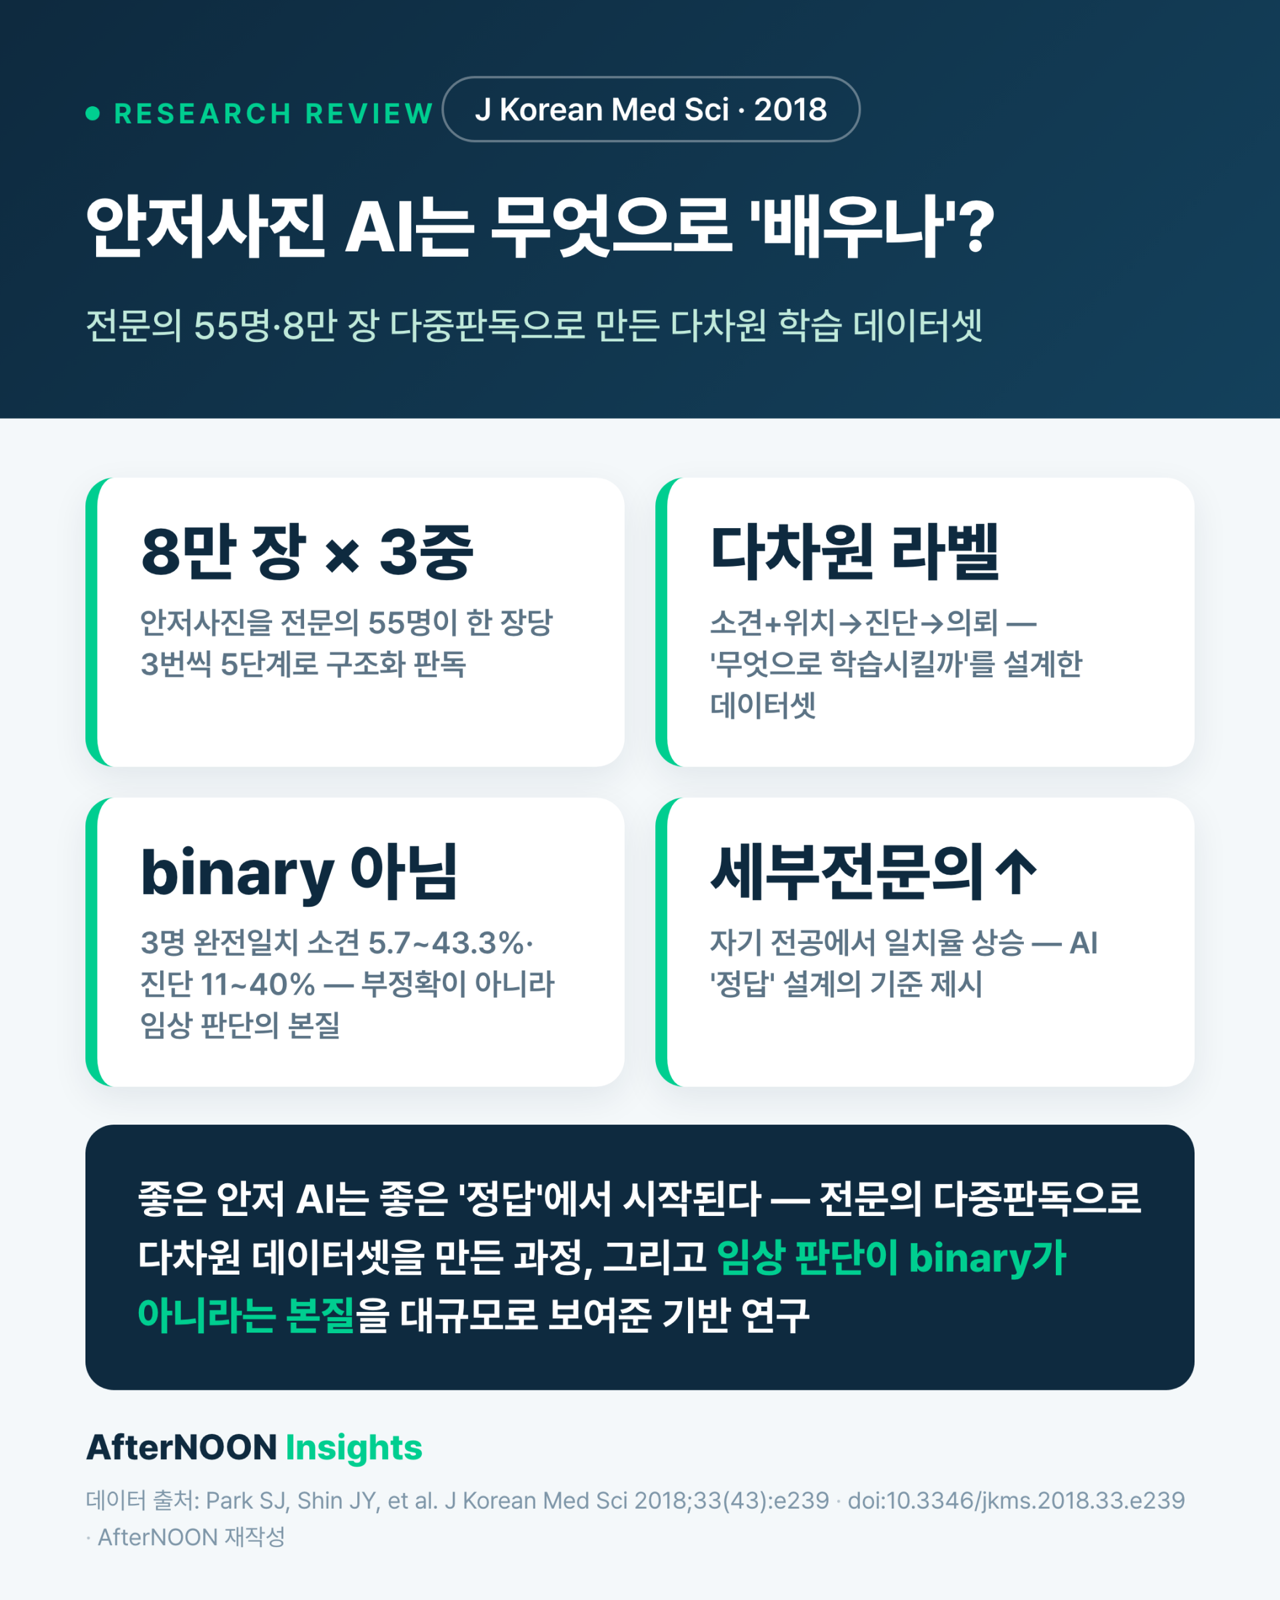 안저사진 AI는 어떻게 ‘배우나’ — 안과의 57명·8만 장으로 만든 다차원 판독 데이터셋 (JKMS 2018 리뷰) — 핵심 요약
*Journal of Korean Medical Science* 2018년 연구 리뷰 (Park·Shin 외)
안저사진을 읽는 AI는 도대체 무엇으로 배우는가? 이 연구의 답은 명확하다 — 잘 정돈된 ‘교과서급 데이터’로 배운다. 이 2018년 *JKMS* 논문은 의료 AI 초창기에, 실제 학습에 쓸 대규모·정제 데이터셋을 만드는 과정 자체를 기록한 작업이다 — 안저사진 약 8만 장을 안과 전문의 55명이 한 장당 3번씩, 5단계(영상화질 → 정상/이상 → 소견+위치 → 진단 → 의뢰 필요성)로 판독하게 한 도구와 그 데이터로 보여준다. 그 과정에서, 같은 사진을 봐도 의사마다 판단이 갈릴 수 있다는 사실 — 임상 판단은 ‘예/아니오’의 이분법이 아니라는 임상의 본질적 특징 — 도 대규모로 정량화됐다.
🔎 이해상충 투명 고지: 본 논문의 공동 1저자이자 교신저자(Sang Jun Park)는 본 플랫폼 운영사(CLOP) 관계자입니다. 논문 Disclosure에 따르면 연구 당시 박상준과 정규환(Kyu-Hwan Jung)은 분석기업 VUNO Inc.의 주주였고 한국 특허(No. 10-1848321, 20-2848322)를 보유했으나, 현재 박상준은 VUNO 지분을 보유하지 않습니다. 공저자 일부(Jaemin Son·Kyu-Hwan Jung)는 연구 당시 VUNO 소속이었습니다. 이 글은 학술 정보 제공을 목적으로 하며, 특정 제품·의료기관·진료의 권유가 아닙니다.
서지정보 · *J Korean Med Sci* 2018;33(43):e239 · PMID 30344460 · DOI 10.3346/jkms.2018.33.e239 · Open Access(CC BY-NC 4.0)
핵심 요약
- 무엇: 안저사진을 5단계(화질 → 정상/이상 → 소견+위치 → 진단 → 의뢰 필요성)로 판독하는 도구를 만들고, 그 도구로 다차원 라벨이 붙은 대규모 데이터셋을 만든 연구.
- 규모: 분당서울대병원 영상에서 79,458장을 안과 전문의 55명이 한 장당 3명씩 독립 판독 → 약 234,242건의 판독을 6개월 만에 수집(분석에는 화질 합격 71,560장 사용).
- 핵심 발상: 진단명만 붙이던 기존 데이터셋과 달리, 소견(finding)을 위치까지 표시하고 ‘소견 → 진단 → 의뢰’의 추론 사슬을 통째로 라벨로 남김 → 두 갈래(소견 기반·진단 직접) 알고리즘 모두에 쓸 수 있음.
- 임상은 binary가 아니다: 의사 3명이 완전히 일치한 비율은 소견 5.7~43.3%, 진단 11.0~40.0% — ‘부정확하다’가 아니라, 같은 사진도 모호한 사례에선 전문가 판단이 갈리는 임상의 본질적 특징을 대규모로 정량화(그만큼 AI 학습용 ‘정답’ 설계가 중요하다는 뜻).
- 의미: ‘좋은 AI’ 이전에 ‘좋은 라벨’이 먼저라는 점, 그리고 세부전문의(망막·녹내장)일수록 자기 영역에서 더 잘 일치한다는 점을 보여 데이터 설계의 기준을 제시.
이 연구가 한 일은?
안저사진(눈 안쪽 망막을 찍은 사진)을 읽는 AI를 만들려면, 먼저 AI가 보고 배울 ‘정답이 달린 사진 묶음’이 있어야 한다. 그런데 병원에 쌓인 기존 판독 기록은 대개 한 의사가 한 번 읽은 것이라 들쭉날쭉하고, 학습에 쓰기엔 정보가 부족했다. 이 연구는 그 ‘교과서’를 제대로 만드는 판독 도구를 설계했다. 의사가 사진을 ① 화질, ② 정상/이상, ③ 어떤 소견이 어디에 있는지, ④ 그래서 무슨 진단인지, ⑤ 안과 의뢰가 필요한지의 5단계로 따라 입력하게 하고, 모든 사진을 3명이 따로 읽게 했다. 그 결과 진단명 하나가 아니라 소견·위치·진단·임상적 의미가 층층이 달린 다차원 데이터셋이 만들어졌고, 동시에 ‘의사들끼리 얼마나 의견이 갈리는가’도 숫자로 측정됐다.
왜 지금 이 논문이 의미가 있나?
[먼저, 쉽게] 2016년 구글이 *JAMA*에 당뇨망막병증 AI 연구를 내놓으며 ‘안저사진 AI’ 붐이 일었다. 사람들은 “영상은 병원에 잔뜩 있으니 데이터는 문제없다”고 생각했다. 그런데 막상 학습을 시켜 보니, 병원에 ‘있는’ 영상과 AI 학습에 ‘쓸 수 있는’ 영상은 전혀 다른 이야기였다. 정답 라벨이 거칠면 아무리 좋은 알고리즘도 거칠게 배운다 — 이 논문은 바로 그 ‘데이터 병목’을 정면으로 다룬다.
[조금 더 깊이] 당시 공개 데이터셋(EyePACS·Messidor 등)이나 병원 내부 데이터는 대부분 사진 1장당 라벨 1개, 그것도 단일 질환(주로 당뇨망막병증)에 집중돼 있었다. 실제 임상은 그렇지 않다 — 한 장의 안저사진에 여러 질환이 겹치고, 하나의 질환도 다양한 소견으로 나타난다. 게다가 구글 Gulshan 연구(2016)는 고성능 알고리즘의 두 전제로 ‘이상 사례가 많은 대규모 개발셋’과 ‘영상당 다중 판독을 갖춘 검증셋’을 꼽았는데, 이를 충족하는 한국형 데이터는 없었다. 이 논문은 그 빈자리를 메우려, 소견과 위치를 묶고(저자들이 “핵심 동기”라 밝힌 부분) ‘소견 → 진단 → 의뢰’ 추론을 그대로 구조화한 다차원·다중판독 데이터셋을 만들었다. 곧 ‘무엇을 학습시킬 것인가’보다 먼저 ‘무엇으로 학습시킬 것인가’를 설계한 연구다.
어떻게 했나? — 도구와 데이터
- 판독 도구(5단계): ① 화질(판독 가능/매체혼탁/작은동공·초점불량/판독불가 등) → ② 정상/이상(이상이 아니면 다음 사진으로 건너뜀) → ③ 소견 16종을 고르고 위치 8구역(황반·이측·상이측·하이측·상비측·하비측·상측시신경·하측시신경)에 표시 → ④ 진단 12종 → ⑤ 안과 의뢰 필요성. 주관식 없이 모두 객관식·이진 선택으로 설계.
- 소견·진단 선정 기준(핵심): 안과 전문클리닉이 아니라 1차 진료·건강검진에서 자주 보이는 빈도를 기준으로 골랐다 — 처음부터 ‘검진용 스크리닝’을 겨눈 설계. 망막박리·망막동맥폐쇄처럼 증상이 뚜렷해 바로 병원에 오는 희귀·응급 소견은 일부러 제외해 카테고리를 단순화.
- 위치 표시 방식: 단순 격자가 아니라 중심와·시신경 중심을 기준으로 한 해부학적 8구역을 자동 생성(딥러닝으로 중심와·시신경 위치 탐지, 판독자가 보정 가능). 의사들이 ‘어디에’를 직관적으로 소통하도록 설계.
- 영상·판독자: 분당서울대병원 망막영상 아카이브(2003.6~2016.6, 112,699명·239,702건)에서 황반 중심 사진을 사용. 비식별화 후 나이·성별만 제공. 판독은 2017년 6~12월, 한국 안과 전문의 55명(망막 16·녹내장 9·각막 3 포함)이 수행. 시스템이 한 사진을 서로 다른 3명에게 자동 배정(같은 사진을 같은 사람에게 다시 주지 않음).
- 분석: 6단계 판독 234,242건 중, 3명 판독이 모두 끝나고 누구도 ‘판독불가’를 주지 않은 71,560장(35,105명)을 분석. 각 항목에서 ‘2명 이상 일치’와 ‘3명 모두 일치’ 비율을 계산하고, 세부전문의 그룹(일반·망막·녹내장)별로 비교.
결과는? — 숫자로
- 수집 규모: 약 6개월간 234,242건 판독 / 79,458장. 이 중 화질 합격·3중 판독 완료 71,560장을 분석. ‘적어도 1명이 이상’으로 본 사진은 34,364장.
- 소견 일치도(step 3): ‘2명 이상 일치’ 비율은 26.7%(망막색소변화)~65.2%(출혈), ‘3명 모두 일치’는 5.7%(망막색소변화)~43.3%(출혈). 가장 잘 맞은 소견은 출혈, 가장 안 맞은 소견은 망막색소변화.
- 진단 일치도(step 4): ‘2명 이상 일치’ 35.6%(기타 망막/맥락막)~65.6%(당뇨망막병증), ‘3명 모두 일치’ 11.0%~40.0%(당뇨망막병증).
- 의뢰 필요성(step 5): ‘안과 의뢰 필요’를 1명 이상 표시한 사진은 17,798장이었으나, 3명 모두 일치는 5.1%에 그쳐 — ‘의뢰가 필요한가’라는 판단조차 의사마다 크게 갈렸다.
- 모호성을 걷어내면 좋아진다: ‘정상/이상’에 3명이 완전히 일치한 16,009장으로 한정하면, 드루젠·신경섬유층 결손(RNFLD)·녹내장성 시신경 변화 등에서 일치율이 뚜렷이 상승(예: 출혈 43.3→56.8%, 막 35.2→55.0%, 녹내장 의심 17.3→42.7%).
- 세부전문의 효과: 자기 전공에서 더 잘 일치 — 망막전문의의 당뇨망막병증 완전일치 55.6%(일반 31.6%·녹내장 45.6%), 녹내장전문의의 ‘녹내장 의심’ 완전일치 38.5%(일반 5.5%·망막 9.4%).
이 논문의 중요성 — 4가지 관점
① 분야 흐름에서의 위치 — ‘알고리즘 경쟁’에서 ‘데이터 인프라’로 시선을 돌린 전환점. 2016~2017년 망막 AI의 주된 화두는 ‘누가 더 정확한 분류기를 만드느냐’였고, 데이터셋은 대개 사진 1장당 단일 질환 라벨 1개(EyePACS·Messidor 등)였다. 이 논문은 경쟁의 무대를 바꿔 ‘무엇으로 학습시킬 것인가’, 즉 소견·위치·진단·의뢰가 층층이 달린 다차원·다중판독 데이터셋의 생성 방법론을 제시했다. 이 데이터셋은 같은 그룹의 2020년 *Ophthalmology* 다중소견 모델(소견→진단 추론을 새긴 해석가능 AI)의 데이터 토대가 됐고, 이후 finding-disease 관계를 다룬 연구(2023년 *Sci Rep* 등, 데이터베이스는 다름)로 이어지는 연구 흐름의 출발점이 됐다.
② 논문 자체의 기여 — 대규모·정제 학습 데이터셋을 만드는 ‘과정’을 설계하고, 임상 판단이 binary가 아님을 정량화. 본질적 신규성은 두 가지다. 첫째, 소견에 위치를 묶고(저자들이 명시한 핵심 동기) ‘소견 → 진단 → 의뢰’ 추론을 그대로 구조화해, 소견 기반·진단 직접의 두 갈래 알고리즘을 모두 학습시킬 수 있는 데이터를 한 번에 만들었다. 둘째, 그 과정에서 3명 완전일치율이 소견 5.7~43.3%, 진단 11.0~40.0%라는 사실을 약 8만 장 규모로 측정했다 — 이는 안저판독이 부정확하다는 뜻이 아니라, 임상 판단이 ‘예/아니오’로 딱 떨어지지 않는다는 임상의 본질적 특징을 대규모 실데이터로 드러낸 것이다. AI 학습용 ‘정답(ground truth)’을 세울 때 이 특징을 반드시 설계에 반영해야 한다는 메시지다.
③ 임상·개발 현장에서의 의미 — ‘좋은 라벨’의 비용을 직시하게 한다. 이 결과는 AI 개발 현장에 직접적이다 — 단일 1회 판독으로 만든 라벨은 위험하고, 다중 판독·세부전문의 배정·모호 사례 정제가 성능과 신뢰의 전제임을 데이터로 보여준다. 동시에 한계도 분명히 한다 — 임상정보(혈압·당뇨병·시력·안압·반대눈)를 가린 ‘연구용 판독’이라 실제 진료보다 일치도가 낮을 수 있다는 점을 저자들이 명시했다. 즉 이 데이터셋은 학습·검증의 기준선이지, 곧바로 진료 결론이 아니다.
④ 한국 + AfterNOON 관점. 한국은 국가검진에서 안저사진이 대량 생산되지만 즉시 판독할 인력이 부족하고, 인종·장비·검사 프로토콜이 다른 해외 데이터로 만든 모델을 그대로 들여올 때 일반화가 문제가 된다 — 이 논문은 그 틈을 메우는 한국인 대규모·다차원 라벨 데이터셋을 분당서울대 실데이터로 구축했다는 점에서 국내 의료기기(SaMD) 임상 근거의 토대가 된다. AfterNOON의 안과 네트워크 기반 DR 스크리닝·RWD 설계에서도, ‘여러 전문의의 구조화된 다중 판독으로 정답을 세우는’ 이 연구의 라벨링 철학은 검진 데이터의 품질·신뢰를 담보하는 직접적인 참조점이 된다.
짚어둘 한계는?
- 낮은 판독자간 일치도: 임상정보를 가린 ‘연구용 판독’이라 실제 진료보다 일치가 낮았을 수 있음(저자 자인). 표준화되지 않은 판독 환경(디스플레이 품질 등)도 일치도를 깎았을 수 있음.
- 소견·진단 단순화: 검진 목적상 출혈의 여러 유형을 ‘출혈’ 하나로 묶는 등 카테고리를 단순화하고 일부 희귀·응급 소견을 제외 — 세밀한 분류가 필요한 연구엔 그대로 쓰기 어려움.
- 위치 정보의 해상도: 픽셀 단위가 아니라 해부학적 8구역 단위라, 픽셀 수준 위치가 필요한 연구엔 제약.
- 후방극부 영상만: 안저 주변부 정보가 없는 황반 중심 사진만 대상.
- 단면적 데이터셋 연구: 이 논문은 ‘데이터셋과 일치도’를 보고한 것으로, 이 데이터로 만든 알고리즘의 전향적 안전성·유효성은 별도 과제(논문도 ‘개발 진행 중’이라 명시).
그래서 무엇을 시사하나?
좋은 안저 AI는 좋은 알고리즘만으로 만들어지지 않는다 — 여러 전문의가, 한 사진을, 여러 번, 구조화된 단계로 읽어 만든 ‘정답’이 먼저다. 이 연구는 그 ‘정답’을 세우는 과정에서 임상 판단이 ‘예/아니오’로 딱 떨어지지 않는다(같은 사진도 전문가 의견이 갈린다)는 임상의 본질을 대규모로 보여줌으로써, AI 성능 보고서를 읽을 때 ‘무엇을, 어떻게 기준(ground truth)으로 삼았는가’를 먼저 따져야 한다는 점을 일깨운다. 검진·원격판독처럼 대량의 안저사진을 다루는 한국 환경에서는, 이런 다차원·다중판독 데이터 설계가 신뢰할 수 있는 스크리닝 AI의 출발선이 된다 — 단, 이는 개발·검증의 기준선일 뿐 진료 결론이 아니며, 실제 활용은 촬영 품질·의뢰 동선·책임 소재가 함께 설계될 때 의미가 있다.
자주 묻는 질문 (FAQ)
Q1. ‘판독자간 일치도(grader agreement)’가 왜 그렇게 중요한가요?
AI는 사람이 붙인 정답(라벨)을 보고 배웁니다. 그런데 임상 판단은 ‘예/아니오’로 딱 떨어지기보다 정도·맥락의 문제인 경우가 많아, 같은 사진도 의사마다 다르게 읽힐 수 있습니다. 이 연구가 일치도를 정면으로 측정한 이유는, ‘좋은 AI’ 이전에 ‘여러 전문의의 판단을 모아 믿을 만한 정답을 세우는 일’이 먼저라는 점을 데이터로 보이기 위해서입니다.
Q2. 의사 3명이 절반도 일치하지 않았다면, 안저판독을 믿을 수 없다는 뜻인가요?
그렇지 않습니다. 이 연구는 진료 상황이 아니라, 혈압·당뇨병·시력 같은 임상정보를 모두 가린 ‘연구용 판독’이었습니다. 실제 진료에서는 추가 정보와 환자 맥락이 있어 일치도가 더 높아질 수 있습니다. 또 ‘정상/이상’이 분명한 사진으로 한정하면 일치율이 크게 올랐습니다. 낮은 수치는 ‘판독이 부정확하다’가 아니라 ‘모호한 사례에서 전문가 의견이 갈린다’는 의미에 가깝습니다.
Q3. 한 사진을 3명이 읽게 한 이유는요?
한 사람이 한 번 읽은 라벨은 실수나 개인차가 그대로 정답이 됩니다. 여러 명이 독립적으로 읽으면 일치/불일치를 구분할 수 있어, 더 믿을 만한 정답을 세우고 ‘얼마나 확실한 정답인가’의 등급도 매길 수 있습니다. 한 장당 3회 판독은 선행 연구에서 비용 대비 효율이 높다고 알려진 방식입니다.
Q4. 이 연구는 AI가 진단을 했다는 건가요?
아닙니다. 이 논문은 AI 모델의 진단 성능을 보고한 것이 아니라, AI가 배울 데이터(교과서)를 만드는 도구와 그 데이터의 특성을 다룬 연구입니다. 이 데이터로 알고리즘을 개발하는 일은 ‘진행 중’이라고 논문에 명시돼 있고, 실제 진단 AI의 성능·안전성은 별도의 연구로 검증해야 합니다.
Q5. 왜 안과가 아니라 ‘검진·1차 진료’에서 흔한 소견을 골랐나요?
이 데이터셋은 처음부터 ‘비교적 건강한 사람을 대상으로 한 스크리닝(선별)’을 겨냥했습니다. 그래서 증상이 뚜렷해 바로 병원에 오는 희귀·응급 소견은 빼고, 검진과 1차 진료에서 자주 마주치는 소견·진단을 중심으로 단순화해 검진용 알고리즘 개발에 적합하도록 설계했습니다.
Q6. 이 연구는 지금 어떤 의미를 갖나요?
이 다차원·다중판독 데이터셋은 같은 그룹의 2020년 다중소견 모델(소견-진단 관계를 모델에 반영한 해석가능 AI)의 토대가 됐고, 이후 관련 후속 연구 흐름으로 이어졌습니다. ‘무엇으로 학습시키는가’가 ‘어떻게 학습시키는가’만큼 중요하다는 점을, 한국인 대규모 데이터로 보여준 기반 연구로 볼 수 있습니다.
더 알아보기
눈 건강과 안과 검사, 그리고 안과 AI에 대한 더 많은 연구 리뷰·정보는 AfterNOON Insights에서 확인하실 수 있습니다 → afternoon.clop.ai
진단과 치료에 대한 판단은 담당 안과 전문의와 상의하세요. (본 글은 학술 정보로, 진단·치료의 근거가 아닙니다.)
출처 (Sources)
- Park SJ, Shin JY, Kim S, Son J, Jung KH, Park KH. A Novel Fundus Image Reading Tool for Efficient Generation of a Multi-dimensional Categorical Image Database for Machine Learning Algorithm Training. *J Korean Med Sci*. 2018;33(43):e239. PMID 30344460. doi:10.3346/jkms.2018.33.e239
- Gulshan V, Peng L, Coram M, et al. Development and validation of a deep learning algorithm for detection of diabetic retinopathy in retinal fundus photographs. *JAMA*. 2016;316(22):2402-2410.
- Ting DSW, Cheung CY, Lim G, et al. Development and validation of a deep learning system for diabetic retinopathy and related eye diseases using retinal images from multiethnic populations with diabetes. *JAMA*. 2017;318(22):2211-2223.
- Krause J, Gulshan V, Rahimy E, et al. Grader variability and the importance of reference standards for evaluating machine learning models for diabetic retinopathy. *Ophthalmology*. 2018;125(8):1264-1272.
- Choi JY, Yoo TK, Seo JG, et al. Multi-categorical deep learning neural network to classify retinal images: a pilot study employing small database. *PLoS One*. 2017;12(11):e0187336.
함께 보면 좋은 글
참고 자료
이 글은 안과 전문의 박상준(분당서울대학교병원 안과)의 감수를 받았습니다.
본 콘텐츠는 일반 건강정보이며, 진단과 치료는 담당 안과 전문의와 상담하세요.